Domain antiquariat24.de kaufen?
Wir ziehen mit dem Projekt
antiquariat24.de um.
Sind Sie am Kauf der Domain
antiquariat24.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain antiquariat24.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Midleton Very Rare - Vintage Release 2023 - Irish WhiskeySeit 1984 setzt jeder Master Distiller von Midleton sein Auge für Details, seine Leidenschaft für hochwertigen Whiskey und seine herausragende Fähigkeit ein, um das Beste an irischem Whiskey zu kreieren – den Very Rare. Die neueste Ergänzung dieser renommierten Kollektion ist mit der Unterschrift des Master Distillers Kevin O'Gorman versehen. Nach einigen Monaten der Erkundung schuf O'Gorman eine ausgewogene Mischung aus seltenen und handverlesenen Single Pot Still und Single Grain Irish Whiskeys aus dem exklusiven Fassvorrat von Midleton. Gereift in leicht ausgebrannten Ex-Bourbon American Oak-Fässern, verwöhnt der Midleton Very Rare 2023 Vintage Release mit dekadenten Aromen, einem verlockenden Duft und 40,0% Vol. Trinkstärke.228,88 €*Versand: 5,88 €Sichere Weiterleitung zum Anbieter
-
IB Laursen Vintage Quilt unifarben Baumwolldecke, 180 x 130 cm, historical blueMach es dir zu Hause so richtig gemütlich mit dem wunderschönen Vintage Quilt der dänischen Marke IB Laursen. Diese hochwertige und kuschelige Decke besticht durch ihr einzigartiges Stonewashed-Finish, das ihr einen authentischen, charmanten Vintage-Look verleiht. Die weiche Wohndecke ist der perfekte Begleiter für gemütliche Stunden auf dem Sofa, als dekorative Tagesdecke im Schlafzimmer oder für entspannte Momente im Garten. Dank der großen Auswahl an wunderschönen, skandinavischen Farben passt sich der Quilt harmonisch jedem Einrichtungsstil an und bringt sofort eine Extraportion Hygge in dein Zuhause.,Die wichtigsten Produktdetails auf einen Blick:,- Marke: IB Laursen,- Material: Obermaterial aus 100% Baumwolle,- Füllung: 100% Polyester,- Pflegeleicht: Maschinenwaschbar bis 30 Grad,- Besonderheit: Stonewashed-Finish für eine extra weiche Haptik,- Vielseitig einsetzbar als Decke, Überwurf oder Plaid79,90 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Midleton Very Rare - Vintage Release 2023 - Irish WhiskeySeit 1984 setzt jeder Master Distiller von Midleton sein Auge für Details, seine Leidenschaft für hochwertigen Whiskey und seine herausragende Fähigkeit ein, um das Beste an irischem Whiskey zu kreieren – den Very Rare. Die neueste Ergänzung dieser renommierten Kollektion ist mit der Unterschrift des Master Distillers Kevin O'Gorman versehen. Nach einigen Monaten der Erkundung schuf O'Gorman eine ausgewogene Mischung aus seltenen und handverlesenen Single Pot Still und Single Grain Irish Whiskeys aus dem exklusiven Fassvorrat von Midleton. Gereift in leicht ausgebrannten Ex-Bourbon American Oak-Fässern, verwöhnt der Midleton Very Rare 2023 Vintage Release mit dekadenten Aromen, einem verlockenden Duft und 40,0% Vol. Trinkstärke.228,88 €*Versand: 5,88 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
IB Laursen Vintage Quilt unifarben Baumwolldecke, 180 x 130 cm, historical blueMach es dir zu Hause so richtig gemütlich mit dem wunderschönen Vintage Quilt der dänischen Marke IB Laursen. Diese hochwertige und kuschelige Decke besticht durch ihr einzigartiges Stonewashed-Finish, das ihr einen authentischen, charmanten Vintage-Look verleiht. Die weiche Wohndecke ist der perfekte Begleiter für gemütliche Stunden auf dem Sofa, als dekorative Tagesdecke im Schlafzimmer oder für entspannte Momente im Garten. Dank der großen Auswahl an wunderschönen, skandinavischen Farben passt sich der Quilt harmonisch jedem Einrichtungsstil an und bringt sofort eine Extraportion Hygge in dein Zuhause.,Die wichtigsten Produktdetails auf einen Blick:,- Marke: IB Laursen,- Material: Obermaterial aus 100% Baumwolle,- Füllung: 100% Polyester,- Pflegeleicht: Maschinenwaschbar bis 30 Grad,- Besonderheit: Stonewashed-Finish für eine extra weiche Haptik,- Vielseitig einsetzbar als Decke, Überwurf oder Plaid79,90 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
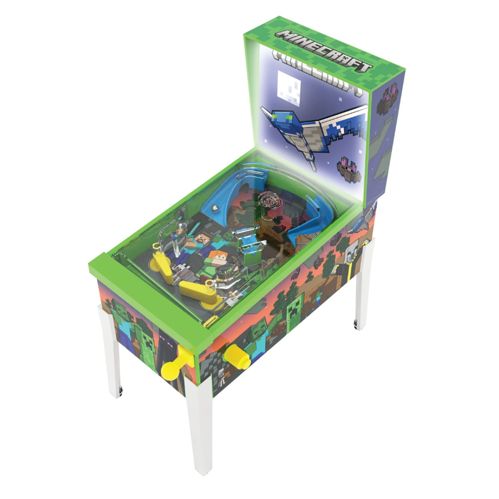
AMBASSADOR Sonic Collectible PinballMit dem Mini-Arcade-Automaten kommt der Nervenkitzel und die Spannung der Spielhalle nach Hause! Beim Pinball wird die Kugel über den federbelasteten Abschusshebel ins Spiel gebracht, während Mini-Flipper für präzise Kontrolle sorgen. Zwei Rampen, ein Spinner und die Zielzone ermöglichen abwechslungsreiche Skill-Shots. Integrierte Lightbox und lizenzierte Musik runden das Arcade-Erlebnis ab.14,39 €*Versand: 3,95 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.